構建高容量大并發數據庫服務 分布式架構設計核心與實踐
在當今數據驅動的時代,業務系統對數據庫提出了前所未有的挑戰:需要處理海量數據(高容量),同時支撐成千上萬甚至百萬級的并發訪問請求(大并發)。傳統的單機數據庫架構已難以滿足這些需求。因此,基于分布式思想的數據庫架構設計,成為實現高容量、大并發數據庫服務的核心路徑。
一、 核心目標與設計原則
設計此類數據庫服務的根本目標是實現可擴展性、高可用性和高性能。為此,需遵循幾個關鍵原則:
- 水平擴展優于垂直擴展:通過增加廉價、標準的服務器節點來提升整體能力,而非不斷升級單臺服務器的硬件。
- 數據分片是基礎:將單一龐大的數據集拆分到多個獨立的數據庫節點上,這是突破單點容量與性能瓶頸的關鍵。
- 冗余與副本保障可用性:任何單點都可能故障,必須通過數據副本(Replica)確保服務持續可用和數據安全。
- 盡可能將計算靠近數據:減少網絡開銷,提升響應速度。
二、 分布式數據庫架構關鍵設計模式
1. 數據分片策略
分片決定了數據如何分布,直接影響擴展性和查詢效率。
- 范圍分片:按某個鍵的范圍(如用戶ID區間、時間范圍)劃分。易于管理,但可能導致數據分布不均(熱點)。
- 哈希分片:對分片鍵進行哈希計算,根據哈希值分配數據。能保證數據均勻分布,但范圍查詢效率低。
- 一致性哈希:哈希分片的優化,在節點增刪時能最小化數據遷移量,被廣泛用于分布式緩存和數據庫系統。
2. 復制與一致性模型
復制提供數據冗余和讀寫分離能力,但引入了數據一致性問題。
- 主從復制:一個主節點負責寫,多個從節點異步同步數據并承擔讀請求。實現簡單,讀擴展性好,但存在數據同步延遲(最終一致性)。
- 多主復制:多個節點均可寫入,需解決寫沖突。適用于多地域部署。
- 基于共識協議(如Raft、Paxos)的同步復制:如NewSQL數據庫所采用,能保證強一致性,但通常以寫入延遲為代價。
3. 無狀態計算與存儲分離
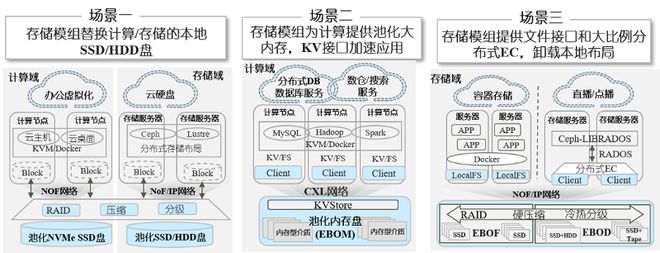
現代云原生數據庫常采用此架構。將負責SQL解析、查詢優化、事務管理的計算層設計為無狀態節點,而將數據持久化存儲在獨立的、可擴展的存儲層(如分布式文件系統、對象存儲或定制的存儲引擎)。這種分離使得計算和存儲可以獨立彈性伸縮。
4. 全局事務管理與分布式查詢
跨分片的事務和復雜查詢是分布式數據庫的難點。
- 分布式事務:可采用兩階段提交(2PC)等協議,但性能開銷大。許多系統選擇放寬一致性(如最終一致性)或使用Saga等長事務解決方案。
- 分布式查詢:查詢引擎需要能將一個SQL查詢分解為能在多個分片上執行的子查詢,并進行結果匯總(如MapReduce思想)。
三、 技術棧選型與實踐路徑
- 路線一:采用成熟分布式數據庫產品
- NewSQL:如TiDB、CockroachDB。它們兼容MySQL或PostgreSQL協議,內置分片、強一致復制和分布式事務,對應用透明,是快速構建服務的首選。
- 云服務商托管服務:如AWS Aurora、阿里云PolarDB。它們基于共享存儲和日志即數據庫理念,提供了類似單機的使用體驗和近乎無限的擴展能力。
- 路線二:基于開源組件自研架構
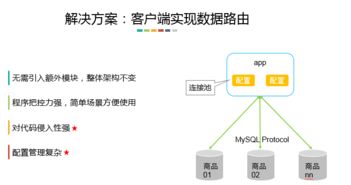
- 分庫分表中間件:使用ShardingSphere、Vitess等。它們在應用層與數據庫之間進行攔截和路由,實現分片和讀寫分離,需要業務層配合。
- “數據庫+”組合方案:例如,用MySQL/PostgreSQL進行分庫分表存儲,用Redis作為緩存和會話存儲,用Elasticsearch處理復雜搜索,用消息隊列解耦異步任務。此方案靈活,但技術復雜度和運維成本高。
四、 實施要點與挑戰
- 分片鍵選擇:至關重要,應選擇查詢頻繁、數據分布均勻的字段,避免跨分片查詢。
- 數據再平衡:當集群節點變化時,系統應能自動平滑地遷移數據,保持負載均衡。
- 監控與運維:分布式系統復雜度呈指數增長,必須建立完善的監控體系(如Prometheus + Grafana),覆蓋每個節點的健康度、性能指標、數據同步延遲等。
- 測試:必須進行大規模的壓力測試、故障注入測試(如Chaos Engineering),驗證系統的彈性與恢復能力。
###
實現高容量大并發的數據庫服務,本質上是將復雜性從使用階段轉移到設計與管理階段。沒有“銀彈”,最佳架構始終取決于具體的業務場景、數據模型和一致性要求。從清晰的原則出發,結合成熟的技術組件,并持續進行容量規劃與性能優化,才能構建出既健壯又高效的分布式數據庫服務體系,為業務的飛速發展奠定堅實的數據基石。
如若轉載,請注明出處:http://www.tinolift.cn/product/32.html
更新時間:2026-11-09 17:02:41